Учитель дал задание переписать код из учебника или разобрать блок-схему алгоритма, а фотография с телефона получилась смазанной или снятой под углом — знакомая ситуация для многих школьников и студентов. В этой статье разберём, как правильно сделать снимок, чтобы задачи по информатике по фото распознавались точно, какие нейросети справляются с чтением кода и схем, и как самостоятельно проверить результат перед тем, как сдать работу.
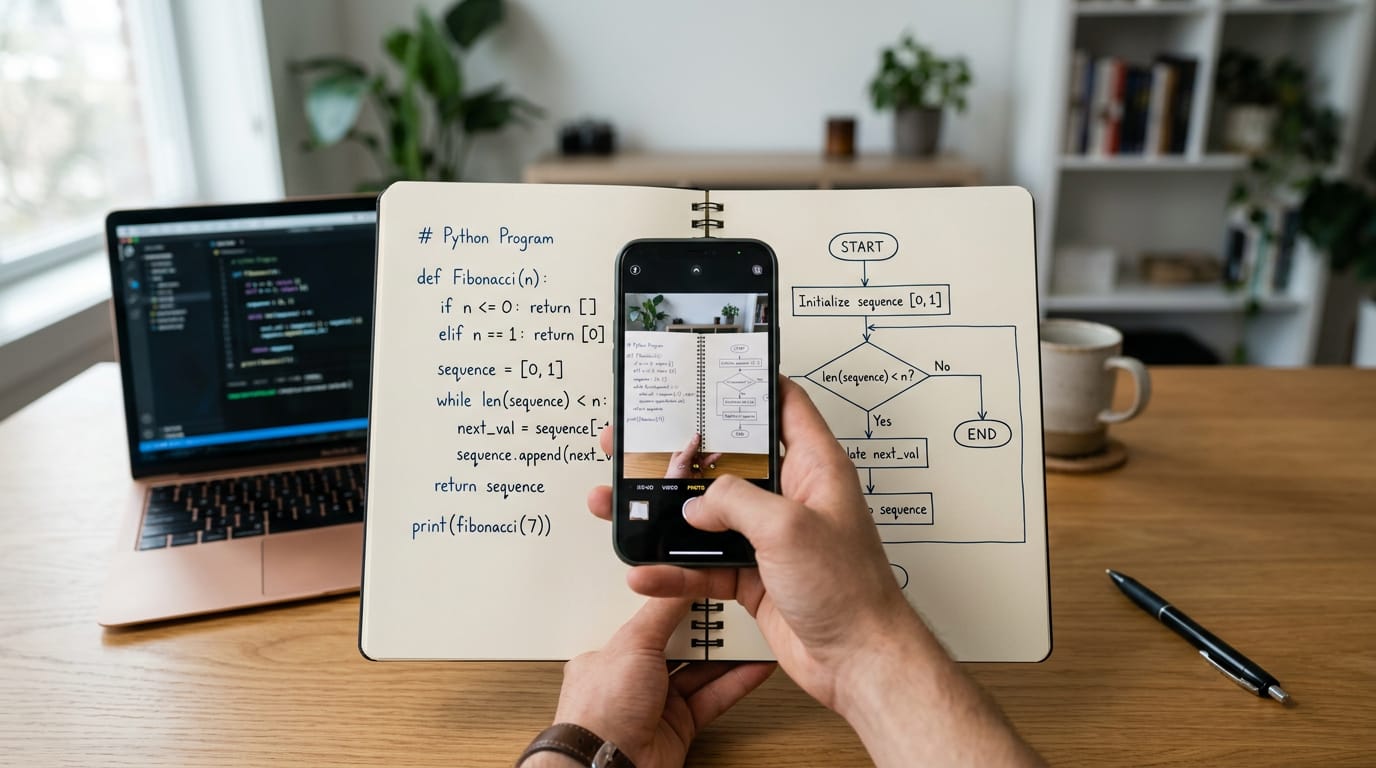
Как правильно сфотографировать задачу с кодом или схемой
Прежде чем загружать снимок в любой сервис распознавания, стоит понять простой принцип: качество результата на 80% зависит от качества исходного фото, а не от «умности» нейросети. Даже самый продвинутый OCR-алгоритм (технология оптического распознавания символов) не восстановит текст, который физически смазан, засвечен или обрезан по краям.
Код и блок-схемы — особенно требовательные объекты для съёмки. В отличие от обычного текста, здесь важна каждая деталь: отступы в коде, направление стрелок в схеме, форма геометрических блоков. Пропущенный или искажённый на фото символ вроде скобки, точки с запятой или знака сравнения может полностью изменить логику алгоритма при разборе.
По данным специалистов в области распознавания изображений, наибольший прирост точности OCR дают три действия: обрезка лишнего фона, выравнивание перспективы и нормализация света и контраста снимка.
Именно поэтому подготовку к фотографированию задачи стоит воспринимать не как формальность, а как первый и решающий шаг в разборе кода или схемы. Ниже — на что обратить внимание, чтобы не переснимать страницу учебника или рабочую тетрадь по три раза.
Освещение, ракурс и фокусировка снимка
Три параметра съёмки определяют, распознает ли нейросеть код или превратит его в бессмысленный набор символов: свет, угол камеры и фокус. Рассмотрим каждый из них отдельно, потому что ошибка в любом из них способна испортить даже идеально написанный текст.
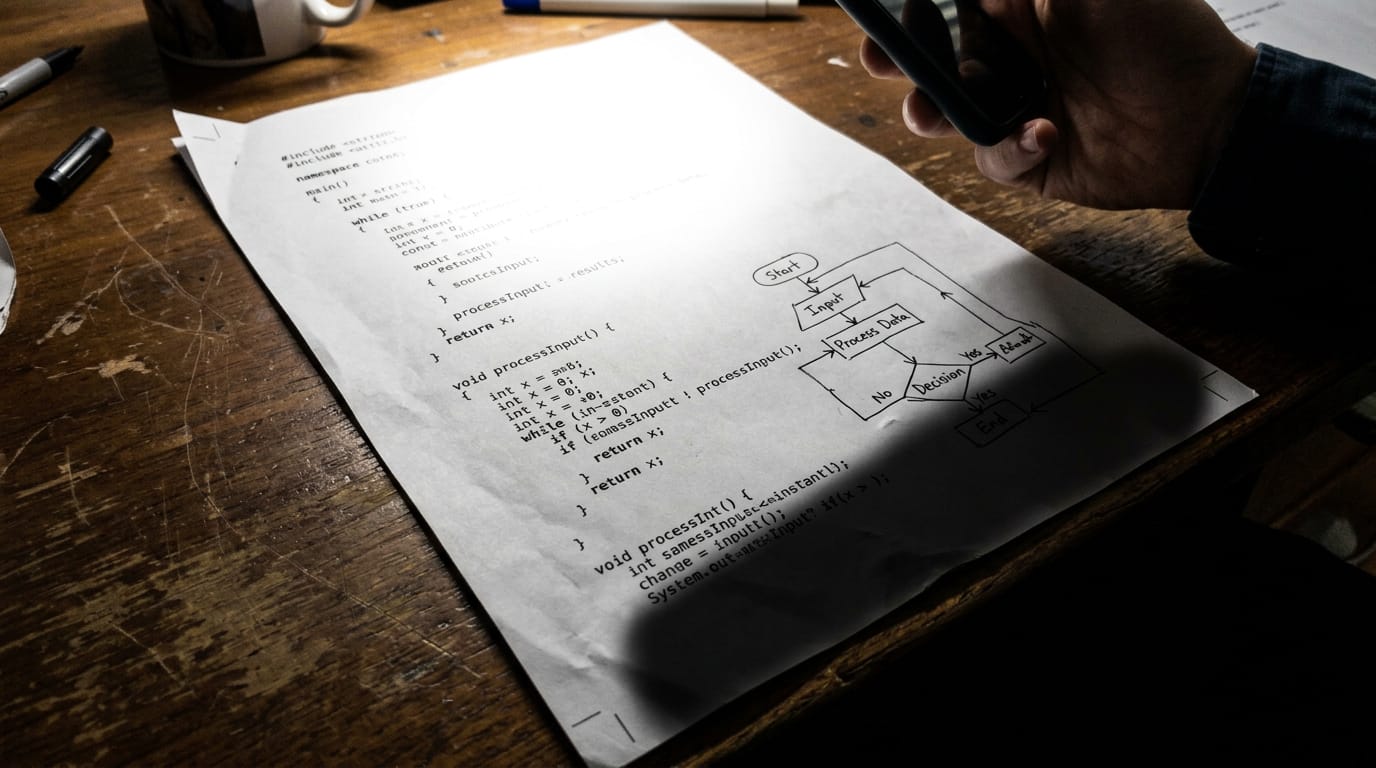
Освещение должно быть равномерным и рассеянным. Идеальный вариант — дневной свет из окна или лампа, направленная сверху под небольшим углом, без прямого попадания на страницу. Прямой верхний свет от точечного источника (например, от вспышки телефона) создаёт блики на глянцевой странице учебника или экране монитора, а тень от руки или самого телефона часто закрывает именно те строки кода, которые нужно распознать.
- Расположите источник света слева или справа под углом 30–45 градусов к странице — это снижает риск бликов.
- Избегайте съёмки против окна или лампы — контровый свет затемняет текст.
- Если снимаете экран монитора, приглушите яркость дисплея и уберите отражения от окна.
Ракурс съёмки должен быть строго перпендикулярным листу или экрану. Даже небольшой наклон камеры искажает пропорции символов — скобки в коде могут «слипнуться» со следующим знаком, а прямые линии блок-схемы визуально перестанут быть прямыми. Это критично для распознавания структуры, ведь алгоритм ориентируется на геометрию строк и отступов.
Финальный параметр — фокусировка. Перед съёмкой стоит слегка коснуться экрана смартфона в области текста, чтобы автофокус подстроился именно под нужную зону, а не под фон. Дрожание рук в момент нажатия кнопки съёмки — частая причина размытия, поэтому лучше упереть локти в стол или использовать таймер на 2–3 секунды.
Практика показывает: наибольший прирост точности распознавания дают именно перпендикулярный ракурс и равномерный рассеянный свет — вместе они устраняют более половины типичных причин ошибок OCR при работе с фото кода и схем.
Как проверить фокус перед отправкой в сервис
Типичные ошибки съёмки, которые портят распознавание
Код и блок-схемы — не обычный текст. У них есть особенность: единственная нечитаемая скобка, точка с запятой или стрелка полностью меняет смысл алгоритма. Поэтому ошибки съёмки, которые для обычного текста дают лёгкую опечатку, для кода превращаются в критический сбой логики. Разберём, какие промахи встречаются чаще всего и почему именно они опасны для программного листинга и схем.
Наклон и перспективные искажения
Съёмка под углом — самая частая причина брака. Когда телефон держат не строго перпендикулярно листу или экрану, верхняя и нижняя строки кода получаются разного масштаба, а вертикальные линии отступов (пробелов и табуляции, критичных для Python) визуально «расходятся». Алгоритм распознавания перестаёт понимать, где заканчивается один уровень вложенности и начинается другой.
При одновременном наличии бликов и наклона страницы более 15° от перпендикуляра ошибки распознавания символов возрастают до 35–50%, особенно на математических и служебных символах — данные тестов на базе Tesseract OCR .
Тени и неравномерная засветка
Тень от руки, корпуса телефона или лампы, падающая на часть экрана или листа, создаёт градиент яркости. Нейросеть может принять край тени за элемент буквы — так фигурная скобка { превращается в круглую (, а стрелка блок-схемы «обрывается» на границе затемнённого участка.
Блики на глянцевых поверхностях
Если код сфотографирован с монитора под углом или распечатка лежит в файле-вкладыше, появляются яркие пятна отражения. Они «выжигают» часть символов, особенно опасно это для тонких элементов: точек, запятых, знаков == и !=, которые легко спутать при частичной засветке.
| Ошибка съёмки | Что происходит с распознаванием | Потеря точности |
|---|---|---|
| Блики на глянцевой бумаге/экране | Символы «выжигаются», путаются похожие знаки | −10–25% |
| Наклон более 15° | Искажаются отступы и структура строк | до −35–50% в сочетании с бликами |
| Тень от руки/телефона | Часть буквы принимается за фон или наоборот | −5–15% |
| Низкое разрешение/зум | Мелкие символы (;, :, ,) сливаются | критично для кода |
Данные обобщены по материалам тестов OCR-систем на текстовых и символьных изображениях.
Специфичные ошибки для кода и схем
- Обрезанные края кадра. Если правая часть строки с закрывающей скобкой или условием цикла не попала в кадр, ИИ либо «додумывает» несуществующий код, либо выдаёт ошибку синтаксиса там, где её нет.
- Смешение похожих символов. OCR регулярно путает
0иO,1иl,Зи3— для кода это фатально, ведьl1иllмогут быть разными переменными . - Снимок нескольких страниц или экранов сразу. Две части листинга в одном кадре сбивают порядок строк, и нейросеть может «склеить» функции из разных файлов.
- Слишком дальний план. Мелкий шрифт кода при удалённой съёмке превращается в нечитаемое пятно, особенно операторы вроде
&&,||,->. - Съёмка экрана монитора вместо экспорта файла. Муар от матрицы экрана и пиксельная сетка добавляют шум, которого не бывает при обычной печатной странице.
Ошибки, характерные именно для блок-схем
У блок-схем есть уникальная зона риска — соединительные линии и стрелки. Если фото смазано из-за дрожания руки или снято с недостаточным фокусом, тонкая линия связи между блоками «условие» и «действие» может визуально пропасть. В результате нейросеть либо теряет ветвь алгоритма, либо неправильно достраивает связь между несоседними элементами.
- Муар
- Волнообразные искажения, возникающие при съёмке экрана или мелкой печатной сетки телефонной камерой; маскирует тонкие линии схем.
- Перспективная трапеция
- Искажение формы прямоугольного листа в трапецию при съёмке не строго сверху; из-за этого прямые углы блок-схемы становятся скошенными и путают алгоритм детекции фигур.
Почему на код ошибки съёмки влияют сильнее, чем на обычный текст
Какие сервисы и нейросети распознают код и алгоритмы по фото
Для распознавания кода и блок-схем по фотографии применяются два принципиально разных класса инструментов. Первый — узкоспециализированные OCR-системы (Optical Character Recognition), «заточенные» только на извлечение символов. Второй — мультимодальные нейросети, которые не просто читают текст, а понимают контекст: язык программирования, логику алгоритма, смысл переменных. Для учебных задач по информатике второй вариант почти всегда предпочтительнее.
Мультимодальные ИИ-ассистенты
Это модели, которые принимают на вход изображение и текстовый запрос одновременно, а на выходе дают не просто «расшифровку», а готовый анализ. Именно они лучше всего подходят для разбора задач по информатике, потому что способны не только прочитать код, но и объяснить, что он делает, и найти в нём ошибку.
| Сервис | Особенности работы с фото кода/схем | Актуальность для России |
|---|---|---|
| ChatGPT (GPT-5 Vision) | Распознаёт фото, скриншоты, PDF, рукописный текст и диаграммы; хорошо восстанавливает синтаксис и отступы | Доступен через VPN или зеркала |
| Gemini | Сильная визуальная аналитика, удобен при работе с таблицами и схемами, сопоставляет несколько фрагментов на одном фото | Ограниченный доступ, нужен VPN |
| Claude | Аккуратно работает с программным кодом и логическими цепочками, подробно объясняет каждый шаг | Ограниченный доступ, нужен VPN |
| YandexGPT / Yandex Vision | Распознаёт печатный и рукописный текст, формулы, схемы и графики на базе сверточных моделей | Полностью доступен в РФ |
| GigaChat | Русскоязычная модель для анализа изображений и текстовых заданий, встроена в экосистему Сбера | Полностью доступен в РФ |
Для пользователей из России практичнее начинать с отечественных сервисов — YandexGPT и GigaChat работают без ограничений и хорошо справляются с распознаванием печатного текста и стандартных конструкций кода. Для сложных многоуровневых алгоритмов и нетривиальных блок-схем зарубежные модели (ChatGPT, Gemini, Claude) в среднем показывают более глубокое понимание логики, но требуют обходных путей доступа.
Специализированные OCR-инструменты для кода
Отдельная категория — сервисы, созданные именно для превращения скриншотов кода в редактируемый текст с сохранением отступов и синтаксиса: Screenshot2Code, FreeAIOCR, FastOCR, инструменты на базе LlamaParse и дообученных версий TrOCR. Их плюс — узкая специализация: они точнее «отечественных» универсальных моделей воспроизводят пробелы, табуляцию и редкие символы вроде ->, &&, ::.
- Сохраняют оригинальную структуру отступов, критичную для Python.
- Распознают моноширинные шрифты IDE точнее универсальных ИИ.
- Работают быстро и часто бесплатно для разовой задачи.
- Не объясняют логику кода и не находят ошибки — только «переводят» картинку в текст.
Точность распознавания текста на чистых скриншотах кода при нормальном разрешении достигает 98–99%, тогда как на фотографиях с телефона (тени, наклон, блики) показатель CER (Character Error Rate) может составлять около 0,11, то есть каждый девятый-десятый символ распознаётся с ошибкой .
Что выбрать для задачи по информатике
Если цель — просто получить редактируемый текст кода со скриншота, достаточно узкого OCR-инструмента. Но для учебной задачи, где важно не только прочитать код, но и понять, разобрать блок-схему или найти баг, нужен мультимодальный ассистент с функцией Vision — он объединяет распознавание и рассуждение в одном запросе.
- Vision (в контексте нейросетей)
- Модуль мультимодальной модели, который анализирует изображения — фотографии, скриншоты, диаграммы — и связывает визуальную информацию с текстовым запросом пользователя.
- CER (Character Error Rate)
- Метрика качества распознавания текста, показывающая долю неверно распознанных символов от общего числа символов в изображении.
Почему не стоит доверять только одному сервису
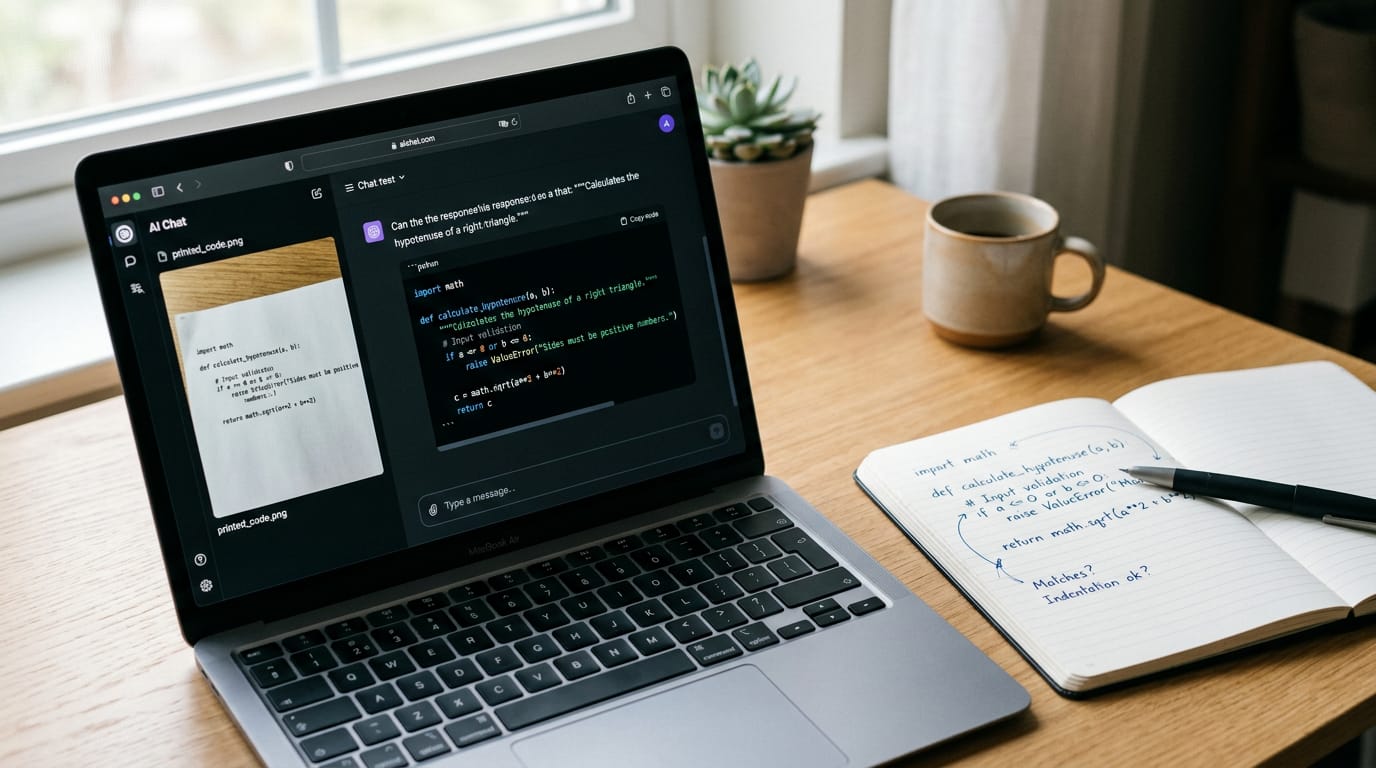
Разбор программного кода по фотографии: пошаговый алгоритм
Когда фото готово и сервис выбран, начинается сам процесс разбора. Здесь важна не хаотичная загрузка «покажи, что тут» — а чёткая последовательность действий, которая минимизирует риск, что нейросеть «додумает» код вместо того, чтобы его честно распознать. Разберём алгоритм по шагам на примере простого фрагмента с циклом.
- Загрузите изображение через функцию Vision. В большинстве современных ассистентов (ChatGPT, Gemini, YandexGPT) это делается через иконку скрепки или прямую вставку скриншота (Ctrl+V) в поле ввода. Максимальный размер файла обычно ограничен 20 МБ, поддерживаются форматы JPG, PNG, WEBP.
- Добавьте текстовую инструкцию к фото. Никогда не отправляйте изображение без пояснения — модель должна понимать, что именно нужно: распознать текст «как есть» или сразу проанализировать логику.
- Попросите вывести код в отдельном блоке. Явное указание «выведи распознанный код в блоке кода с сохранением отступов» снижает риск, что ИИ незаметно «нормализует» синтаксис под свои привычки.
- Сверьте построчно с оригиналом. Особое внимание — на скобки, кавычки, операторы сравнения и уровни вложенности циклов.
- Запросите отдельное объяснение работы кода. Только после проверки текста просите модель описать, что делает программа — это второй, независимый уровень анализа.
Если задача взята не с фотографии учебника, а требует поиска готового решения похожего примера, иногда быстрее сверить логику с разбором на специализированных образовательных ресурсах — например, с https://www.euroki.org/gdz-po-foto, где решения задач можно найти по фотографии условия.
Пример корректного запроса и результата
Допустим, на фото — фрагмент кода на Python с циклом суммирования чётных чисел. Правильный запрос выглядит так: «Распознай код с фото точно посимвольно, выведи его в блоке кода с сохранением отступов, не исправляй и не оптимизируй».
| Шаг | Действие пользователя | Типичная ошибка на этом шаге |
|---|---|---|
| 1 | Загрузка фото | Слишком общий формат без уточнения типа файла |
| 2 | Формулировка запроса | Просьба «реши задачу» без просьбы сначала показать распознанный текст |
| 3 | Получение кода | Модель «улучшает» синтаксис вместо точной передачи |
| 4 | Проверка построчно | Пользователь пропускает этот шаг и сразу верит результату |
| 5 | Объяснение логики | Запрос объяснения до проверки текста кода |
Мультимодальные модели вроде GPT-5 Vision и Gemini способны анализировать не только фотографии и скриншоты, но и PDF-документы с рукописными пометками, восстанавливая структуру исходного текста, включая отступы программного кода .
Почему нельзя пропускать промежуточный шаг
Главная ошибка новичков — просить сразу «реши эту задачу по фото», минуя этап проверки распознанного текста. В этом случае, если ИИ ошибся хотя бы в одном символе (например, принял <= за <), решение будет построено на неверных исходных данных, а пользователь не узнает об этом, пока не сравнит вручную.
- Промежуточная валидация
- Этап проверки, на котором распознанный текст кода сверяется с оригинальным фото до того, как модель начинает анализировать логику или искать ошибки.
Что делать, если код не помещается на одном фото
Как ИИ распознаёт синтаксис и переменные на снимке кода
В основе современных мультимодальных нейросетей лежит архитектура Vision Transformer (ViT) — она обрабатывает изображение не так, как классический OCR построчно «сканирует» текст, а разбивает картинку на сетку небольших квадратов, обычно 16×16 пикселей, называемых патчами . Каждый патч превращается в вектор — своего рода «визуальный токен», аналогичный слову в тексте.
Дальше вступает механизм self-attention (внимание к себе): модель анализирует, какие патчи связаны друг с другом, даже если они находятся в разных частях изображения . Именно это позволяет ИИ «понять», что открывающая скобка в начале строки логически связана с закрывающей далеко внизу — то, с чем построчный OCR справляется намного хуже.
- Изображение делится на патчи фиксированного размера, каждый охватывает небольшой фрагмент символов.
- Патчи преобразуются в векторы (эмбеддинги) с добавлением позиционной информации — модель запоминает, где именно находился каждый фрагмент.
- Трансформер обрабатывает последовательность патчей, сопоставляя их друг с другом через self-attention.
- Визуальные токены объединяются с текстовыми в едином пространстве, что позволяет модели «рассуждать» над распознанным кодом сразу в контексте запроса пользователя .
Благодаря позиционным эмбеддингам модель сохраняет информацию о пространственном расположении каждого патча — а значит, способна восстановить количество пробелов перед строкой кода, то есть уровень отступа. Это критично для языков с отступо-зависимым синтаксисом, где Python — самый яркий пример: разница между вложенным и невложенным блоком кода равна всего нескольким пробелам.
| Элемент кода | Как ИИ распознаёт | Риск ошибки |
|---|---|---|
| Отступы (Python) | По позиционным эмбеддингам и расстоянию от левого края | Высокий при наклоне фото |
| Имена переменных | Через сопоставление патчей символов в контексте всей строки | Средний — путает похожие буквы |
| Операторы (==, !=, <=) | По форме и относительному положению символов друг к другу | Высокий при низком разрешении |
| Скобки и кавычки | Через self-attention, связывающий открывающий и закрывающий символ | Средний |
Отдельная сложность — переменные. Модель не хранит словарь «правильных» имён переменных, как в текстовом языке, где слово можно проверить по частотности. Вместо этого она пытается сохранить консистентность: если в начале листинга переменная называется total_sum, модель постарается использовать то же имя во всех остальных строках, даже если на фото буква смазана.
«Фрагменты — это токенизатор для изображений. Подобно тому, как мы разбиваем текст на токены, мы разбиваем изображения на фрагменты. Это преобразует двумерную пространственную структуру в последовательность, которую могут обрабатывать трансформеры» — из описания архитектуры визуальных моделей .
- Патч (patch)
- Небольшой квадратный фрагмент изображения (обычно 16×16 пикселей), который Vision Transformer обрабатывает как отдельный визуальный токен.
- Self-attention
- Механизм, позволяющий модели определять, какие части входных данных (патчи изображения или слова текста) наиболее значимы друг для друга при формировании общего понимания.
Почему модель иногда «исправляет» синтаксис без разрешения
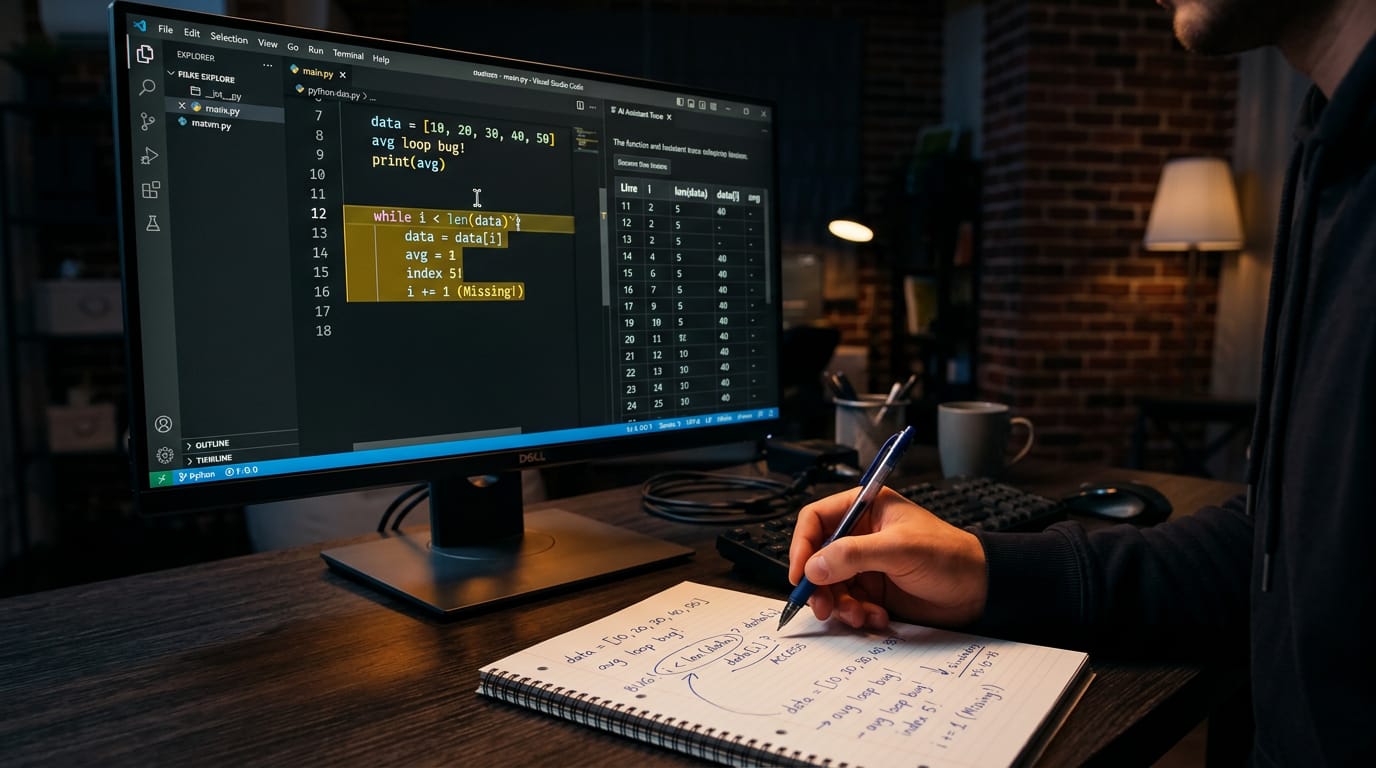
Поиск ошибок и логических багов в распознанном коде
После того как код точно перенесён с фото в текст, начинается вторая часть работы — поиск багов. Важно различать три типа ошибок, потому что каждый требует своей тактики проверки: одну модель находит мгновенно, а другую можно пропустить, даже глядя на код внимательно.
| Тип ошибки | Как проявляется | Как искать |
|---|---|---|
| Синтаксическая | Программа не запускается, интерпретатор указывает строку и символ | Проверка скобок, кавычек, двоеточий, отступов |
| Ошибка выполнения | Программа падает во время работы (деление на ноль, выход за границы массива) | Проверка входных данных, обработка исключений |
| Логическая | Программа работает, но выдаёт неверный результат — без единой строки об ошибке | Тесты, ручная трассировка, сравнение с ожиданием |
Логическая ошибка — самая коварная категория именно потому, что интерпретатор считает код полностью корректным . Программа отработает от начала до конца, выдаст ответ — и этот ответ будет просто неправильным, без единого намёка на причину.
Частые причины багов в учебных задачах
- Перепутанное условие в операторе ветвления — например,
<вместо<=. - Ошибка на границе цикла (off-by-one) — цикл выполняется на одну итерацию больше или меньше нужного.
- Неверный порядок операций из-за забытых скобок в математическом выражении.
- Путаница с областью видимости переменной — переменная объявлена внутри функции, но используется снаружи.
- Ошибка преобразования типов — например, деление целых чисел вместо вещественных.
По данным анализа типичных ошибок начинающих программистов, среди синтаксических багов чаще всего встречаются пропущенная точка с запятой (38,2% случаев) и ошибки в расстановке скобок (26,7%) — именно эти два типа символов OCR путает при фотосъёмке чаще остальных .
Как правильно попросить ИИ найти баг
Просьба «найди ошибку» слишком общая — модель может ответить формально, не проверив логику глубоко. Точнее работает запрос с чётким алгоритмом проверки:
- Укажите, что код должен делать — опишите ожидаемый результат словами.
- Приведите конкретный пример входных данных и то, что программа выдаёт вместо правильного ответа.
- Попросите модель выполнить трассировку — пошаговый разбор значений переменных на каждой итерации цикла .
- Отдельно уточните, нет ли ошибки на границах цикла (первая и последняя итерация проверяются особенно тщательно).
Например: «Этот код должен считать сумму чётных чисел от 1 до 10, но выдаёт 30 вместо 30. Проверь, правильно ли работает условие в цикле, и покажи значения переменных на каждом шаге» — такой запрос заставляет модель не угадывать, а действительно трассировать выполнение.
- Трассировка
- Метод отладки, при котором значения всех переменных программы фиксируются после выполнения каждой команды — позволяет увидеть точный момент, когда результат становится неверным.
- Off-by-one
- Разновидность логической ошибки, при которой цикл или индекс смещён ровно на одну позицию — частая причина некорректного количества итераций.
Почему нельзя слепо доверять первому ответу ИИ об ошибке
Разбор блок-схем и алгоритмов по фото
Блок-схема требует от нейросети другого типа анализа, чем текстовый код. Здесь важна не только OCR-расшифровка надписей внутри фигур, но и понимание геометрии: какая линия соединяет какой блок, где начинается ветвление и куда возвращается цикл. Современные модели решают эту задачу в несколько этапов — сначала находят и классифицируют фигуры, затем связывают их стрелками, и только потом формируют текстовое описание логики.
Исследователи описывают этот процесс как трёхступенчатый конвейер: детекция узлов и концов стрелок, оптическое распознавание текста внутри блоков, и сборка структурированного запроса для языковой модели, которая уже интерпретирует граф как алгоритм. Такой подход применяют, например, в фреймворках на основе Segment Anything Model (SAM) для сегментации фигур и OCR для извлечения текста из каждого блока.
В научной работе по автоматическому разбору блок-схем (arXiv, 2025) конвейер распознавания включает семь последовательных стадий — от детекции стрелок до генерации вопросов и логического вывода на основе визуально-языковой модели (VLM). Это подчёркивает, что блок-схема — визуально более сложный объект для ИИ, чем однородный текст кода.
Прежде чем нейросеть построит из фотографии рабочий псевдокод, она проходит через типовые «точки риска» распознавания. Их стоит знать, чтобы заранее оценить, насколько можно доверять результату.
- Слипшиеся фигуры — если ромб условия почти касается прямоугольника процесса, границы на фото могут «слиться», и ИИ ошибочно объединит два блока в один.
- Неявные стрелки — тонкие или прерывистые линии связи, особенно нарисованные от руки, распознаются хуже жирных чётких линий из ГОСТ-шаблонов.
- Пересечения линий потока — по ГОСТ 19.701-90 пересечения нежелательны, но на студенческих чертежах встречаются часто, и это главная причина, по которой ИИ путает порядок выполнения шагов.
- Возврат цикла без явной стрелки-указателя — если линия цикла идёт «в обход» и слабо выделена, модель может интерпретировать её как отдельную ветвь, а не как повтор.
Работа с блок-схемой всегда начинается с того же, что и с кодом: внимательной подготовки фото. Но здесь добавляется ещё один шаг — проверка целостности графа, то есть того, что у каждого блока есть вход и хотя бы один выход, а стрелки не «висят в воздухе».
- Загрузите фото в чат с ИИ и явно укажите, что это блок-схема алгоритма, а не текст программы — это меняет режим анализа модели.
- Попросите нейросеть перечислить все найденные блоки по порядку с указанием их типа (терминатор, процесс, решение, цикл) и текста внутри.
- Сверьте список блоков с оригиналом на фото — если модель «потеряла» один из ромбов условия, распознавание логики будет неполным.
- Уточните направление стрелок в местах ветвления: попросите явно назвать, какой блок выполняется при ответе «да», а какой — при «нет».
- Только после проверки структуры просите ИИ перевести схему в псевдокод или готовый код на нужном языке.
Отдельная сложность — учебные блок-схемы, которые не всегда строго соответствуют стандарту. Студенты часто рисуют условие прямоугольником вместо ромба или подписывают цикл произвольным текстом без символа границы цикла. ИИ, обученный на «правильных» схемах, в таких случаях может домысливать форму по контексту надписи, а не по геометрии — это источник скрытых ошибок.
Почему форма фигуры важна даже при плохом качестве фото
Главный принцип на этом этапе — не принимать первый же ответ модели как окончательный. Блок-схема, в отличие от линейного текста кода, допускает несколько визуально похожих, но логически разных интерпретаций одного и того же снимка, поэтому перекрёстная проверка структуры перед переводом в код обязательна.
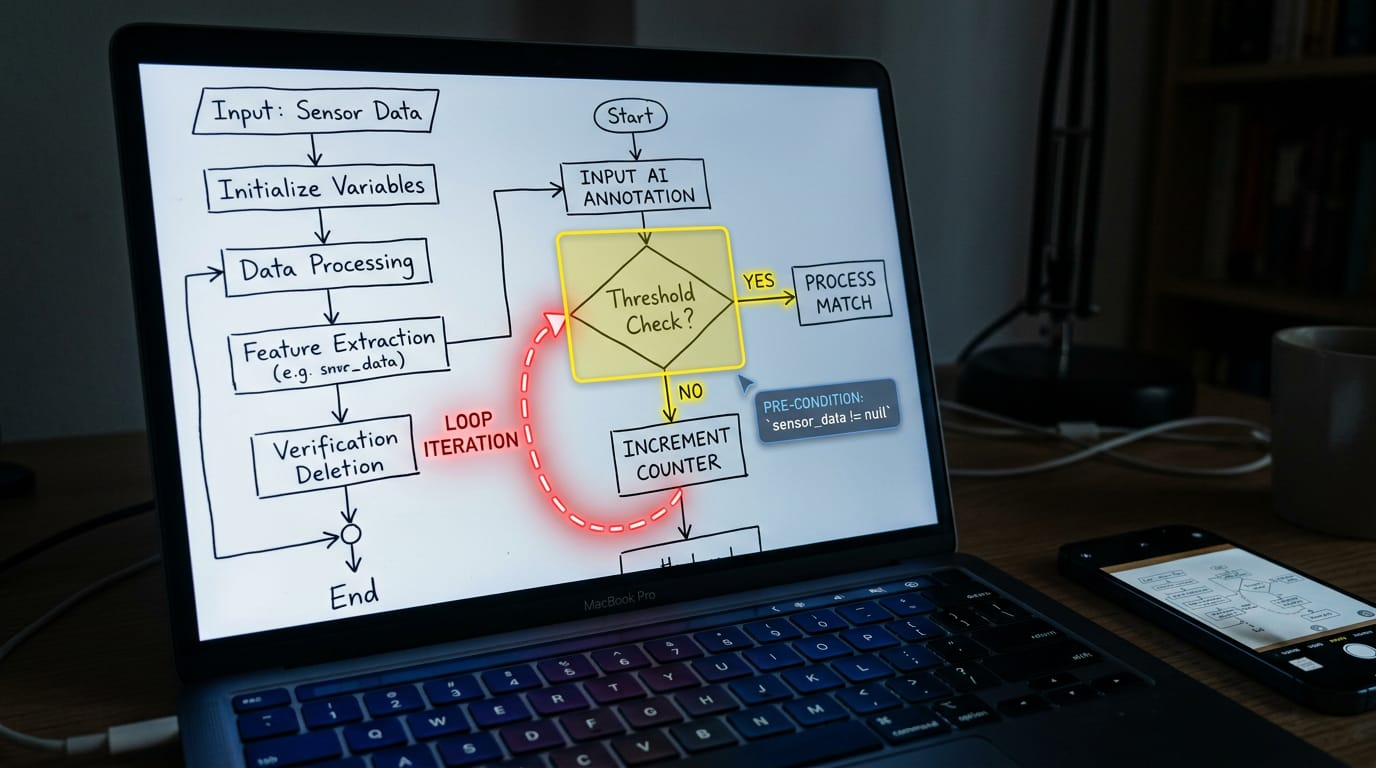
Расшифровка элементов блок-схемы: от условий до циклов
После того как модель перечислила блоки и сверила их с оригиналом, начинается следующий этап — интерпретация смысла каждой фигуры. Здесь важно понимать, по каким визуальным признакам ИИ отличает условие от цикла и простое ветвление от вложенной конструкции, потому что именно на этом этапе чаще всего рождаются логические искажения, незаметные при поверхностной проверке.
Базовый набор фигур задан ГОСТ 19.701-90: овал-терминатор обозначает начало и конец алгоритма, прямоугольник — процесс (вычисление или присваивание), параллелограмм — ввод-вывод данных, а ромб — блок решения с одним входом и минимум двумя альтернативными выходами. Нейросеть определяет тип блока не только по форме контура, но и по количеству исходящих линий: если из фигуры выходит две стрелки с подписями «да»/«нет» или «true»/«false», модель классифицирует её как условие, даже если на фото контур больше похож на прямоугольник со срезанными углами.
- Простое ветвление
- Ромб с двумя исходящими стрелками, которые расходятся, а затем сходятся в одной точке дальше по схеме — соответствует конструкции if / else без возврата назад.
- Цикл с предусловием
- Ромб, у которого одна из исходящих стрелок ведёт вперёд по основному потоку, а вторая — в тело цикла, откуда линия возвращается назад к тому же ромбу. Условие проверяется до выполнения тела — аналог while.
- Цикл с постусловием
- Тело цикла выполняется первым, а проверка условия (ромб) стоит после него; стрелка возврата идёт от ромба обратно к началу тела — аналог do-while или repeat-until.
Именно направление стрелки возврата — ключевой признак, по которому ИИ отличает цикл от обычного ветвления. Если стрелка идёт «вверх и назад» к уже пройденному блоку, это почти всегда цикл; если все линии текут только «вперёд и вниз», перед моделью простая последовательность условий. Проблема в том, что на фото плохого качества эта стрелка может визуально слиться с соседней линией потока, и тогда ИИ ошибочно превращает цикл в линейный набор шагов, которые выполняются один раз.
По ГОСТ 19.701-90 нормальным направлением линий потока считается движение сверху вниз и слева направо; любое отклонение от этого правила — стрелка, идущая вверх или влево, — визуально сигнализирует о цикле или переходе назад по схеме, и распознающая модель использует именно это правило как эвристику при отсутствии специального символа «граница цикла».
Отдельная конструкция в ГОСТе — символ границы цикла: он состоит из двух частей с общим идентификатором, которые отмечают начало и конец цикла с параметром (аналог for). Внутри символа обычно указано условие инициализации, приращения и завершения — например, «i = 1, 10, 1». На студенческих чертежах этот составной символ часто заменяют обычным ромбом с ручной подписью, и тогда нейросети приходится домысливать тип цикла по семантике надписи, а не по стандартной форме.
Вложенные конструкции — цикл внутри условия или условие внутри цикла — распознаются сложнее всего, потому что требуют от модели удержания иерархии блоков на протяжении всего графа. Здесь полезно не просто спросить «переведи схему в код», а явно попросить ИИ указать, какие блоки находятся внутри тела цикла, а какие — вне его, прежде чем переходить к следующему шагу.
- Уточните для каждого ромба: это разовое ветвление (если после разделения ветки сходятся и не возвращаются) или условие цикла (если хотя бы одна ветка ведёт назад).
- Спросите явно, куда указывает стрелка возврата — на сам ромб условия (предусловие) или на первый блок тела цикла (постусловие).
- Для составных символов границы цикла попросите отдельно назвать переменную-счётчик, начальное и конечное значение, шаг приращения.
- При вложенных блоках попросите модель перечислить, какие узлы входят «внутрь» каждого цикла или условия, а не просто дать линейный список сверху вниз.
Почему модель иногда путает вложенный цикл с последовательностью двух циклов
Перевод блок-схемы в псевдокод или программу
Когда список блоков и направления стрелок сверены с оригиналом, наступает финальный этап — трансляция графа в текст. Здесь важно не спешить сразу к готовому коду на Python или C++, а сначала получить промежуточный псевдокод: он проще для проверки, потому что не отвлекает синтаксисом конкретного языка и позволяет сфокусироваться только на логике.
В российской учебной традиции псевдокод чаще всего оформляется по школьно-вузовскому шаблону с ключевыми словами алг, нач, кон, а ветвления и циклы записываются через если — то — иначе — все и нц — кц. Если явно попросить нейросеть использовать именно эту нотацию, а не англоязычный псевдокод с if/while/for, результат легче сопоставлять с российскими методичками и требованиями преподавателя.
- Ветвление на псевдокоде
- Ромб с двумя исходящими стрелками превращается в блок если [условие] то [действие1] иначе [действие2] все — без слова «иначе», если вторая ветка на схеме отсутствует.
- Цикл с предусловием
- Записывается как нц пока [условие] [тело цикла] кц — условие в заголовке проверяется перед каждым проходом тела.
- Цикл с параметром
- Составной символ границы цикла со счётчиком переводится в нц для i от [начало] до [конец] [тело цикла] кц, где шаг указывается отдельно, если он не равен единице.
Порядок действий на этом шаге стоит соблюдать строго — попытка получить готовый код сразу, без промежуточного псевдокода, чаще всего маскирует ошибки распознавания структуры, которые потом не видно за синтаксисом языка программирования.
- Попросите ИИ перевести проверенную структуру блоков в псевдокод построчно, явно указав нотацию (алг/нач/кон или if/while/for — в зависимости от того, что привычнее).
- Сверьте количество строк псевдокода с количеством содержательных блоков на фото — если блоков было семь, а строк логики получилось четыре, часть шагов модель «слила» в один.
- Отдельно проверьте вложенность: каждый нц должен иметь свой кц, а каждое если — свой все; разбалансированность здесь почти всегда сигнал потерянного блока.
- Только после проверки псевдокода попросите перевести его в конкретный язык программирования, указав язык явно — иначе модель выберет его по своему усмотрению.
- Запустите получившийся код мысленно на тестовом наборе данных, который легко посчитать вручную, и сравните результат с ожидаемым по смыслу задачи.
Отдельная ловушка — схемы, где один и тот же блок вычисления встречается в теле цикла и после него. Нейросеть иногда «выпрямляет» такую структуру, дублируя код там, где на самом деле нужен один блок с повторным вызовом, — это визуально рабочий, но избыточный и менее точный перевод оригинальной логики.
| Элемент схемы | Псевдокод (рос. нотация) | Python |
|---|---|---|
| Ромб условия | если x > 0 то ... иначе ... все | if x > 0: ... else: ... |
| Цикл с предусловием | нц пока x < 10 ... кц | while x < 10: ... |
| Цикл с параметром | нц для i от 1 до 10 ... кц | for i in range(1, 11): ... |
| Цикл с постусловием | нц ... кц при x >= 10 | while True: ...; if x >= 10: break |
В методических материалах по школьному курсу информатики псевдокод определяется как промежуточное представление алгоритма между естественным языком и языком программирования — форма, достаточная для однозначной интерпретации человеком и лёгкой трансляции в любой конкретный синтаксис. Именно поэтому пропуск этого шага при разборе схемы по фото повышает риск скрытых логических искажений.
Что делать, если схема смешивает стандартную и произвольную нотацию
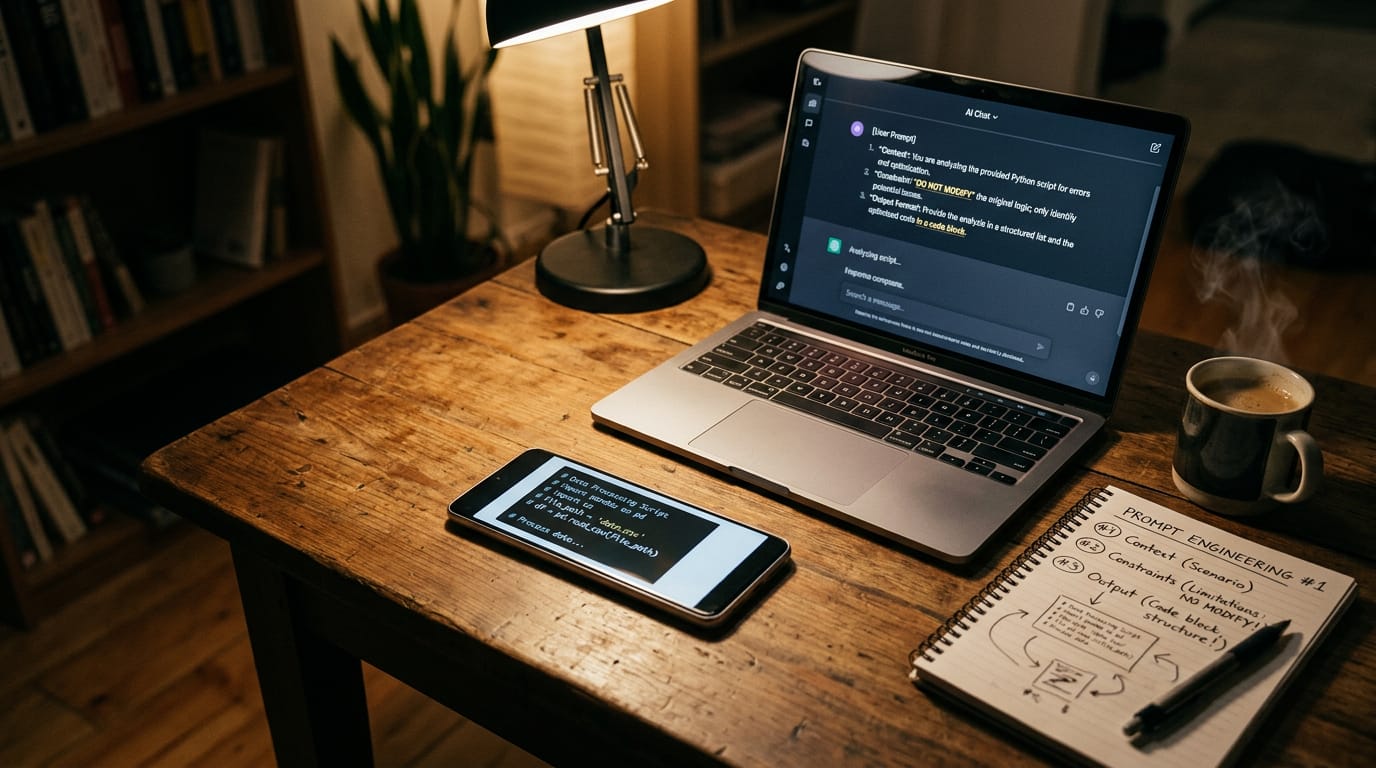
Как составить точный запрос для ИИ по загруженному фото
Качество фото и выбор сервиса задают верхнюю границу точности, но конкретный результат определяет формулировка запроса. Одно и то же изображение кода или блок-схемы может дать совершенно разный ответ в зависимости от того, как построен промпт — расплывчатое «объясни этот код» и структурированный запрос с явными ограничениями приводят к разным по надёжности результатам, даже когда фото идентично.
Главная ошибка новичков — просить сразу всё и сразу: распознавание, объяснение и исправление ошибок в одном сообщении. Модель в этом случае экономит внимание на каждом этапе и чаще домысливает детали. Разработчики промпт-инженерии для vision-моделей формулируют это как принцип декомпозиции задачи: сложный запрос стоит разбивать на пошаговые подзадачи с чёткими промежуточными результатами, а не пытаться получить готовый анализ за один шаг.
Руководство Microsoft по инженерии промптов для vision-моделей прямо рекомендует «разбивать сложные запросы на управляемые подцели по шагам» и явно указывать желаемый формат вывода — markdown, таблицу или блок кода, — потому что модель без такой инструкции сама выбирает формат, который не всегда удобен для дальнейшей проверки.
Хорошо построенный запрос к фото с кодом или схемой обычно содержит четыре обязательных элемента. Их отсутствие — самая частая причина, когда результат «вроде похож на правильный», но при сверке с оригиналом обнаруживаются искажения.
- Контекст — тип объекта на фото (код на конкретном языке, блок-схема алгоритма, часть большого листинга) и то, что нужно получить на выходе.
- Ограничение на этапе распознавания — прямой запрет «исправлять», «улучшать» или домысливать синтаксис, если что-то на фото нечитаемо.
- Формат вывода — блок кода с сохранением отступов, нумерованный список блоков схемы, таблица для сравнения найденных элементов.
- Явное разделение шагов — сначала распознавание, потом (после вашей проверки) анализ логики или перевод в другой язык.
- Zero-shot запрос
- Промпт без примеров и без описания формата — «что здесь написано?». Подходит для черновой оценки, но даёт наименее предсказуемый результат на технических изображениях.
- Task-oriented запрос
- Промпт, сфокусированный на одной конкретной задаче с явным форматом вывода — «распознай код построчно и выведи в блоке кода без изменений». Рекомендуемый вариант для первого шага работы с фото.
- Chain-of-thought запрос
- Промпт, который просит модель рассуждать поэтапно — «сначала перечисли все блоки схемы, затем стрелки между ними, и только потом переведи в псевдокод». Снижает число ошибок на сложных структурах за счёт принудительной декомпозиции.
Для разных типов изображений структура запроса немного отличается, но общий принцип — идти от простого к сложному — остаётся неизменным. Ниже пример того, как можно сформулировать запрос для кода и для блок-схемы.
| Объект на фото | Пример формулировки первого шага | Что запрашивать на втором шаге |
|---|---|---|
| Код (листинг программы) | «Распознай код на фото построчно, сохрани отступы и регистр символов, ничего не исправляй, выведи в блоке кода» | «Найди логическую ошибку через трассировку переменных на тестовых данных» |
| Блок-схема алгоритма | «Перечисли все блоки схемы по порядку с типом фигуры (терминатор, процесс, решение) и текстом внутри» | «Переведи проверенную структуру в псевдокод с ключевыми словами если/иначе/нц/кц» |
Отдельное правило касается количества фотографий в одном запросе. Если задача занимает несколько кадров — например, длинный листинг кода или сложная многоярусная схема, — не стоит загружать более 5–7 изображений одновременно: по наблюдениям практиков prompt-инженерии, качество анализа у большинства мультимодальных моделей заметно снижается при работе с большим числом картинок в одном сообщении, модель начинает путать порядок фрагментов и терять связи между ними.
Формулировка запроса должна также явно называть язык вывода и нотацию, если она важна: без этого уточнения модель может ответить псевдокодом на английском или выбрать язык программирования произвольно, что усложняет сравнение с методичкой или условием задачи из учебника.
Пример неудачного и удачного промпта для одного и того же фото
Проверка и самостоятельный анализ полученного решения
Полученный от нейросети код или псевдокод из блок-схемы — это черновик, а не готовый ответ. Модель могла неточно распознать символ, «улучшить» синтаксис по своему усмотрению или ошибиться в логике при переводе схемы в текст. Поэтому финальный этап работы с фото-задачей — это не копирование результата, а его самостоятельная верификация.
Три уровня проверки результата
Прежде чем сдавать или использовать решение, полезно пройти три последовательных уровня контроля — от буквы к смыслу.
- Сверка текста с оригиналом. Построчно сравнить распознанный код или список блоков схемы с фотографией: совпадают имена переменных, знаки препинания, направления стрелок.
- Проверка синтаксиса и структуры. Убедиться, что код компилируется или интерпретируется без ошибок, а в схеме нет разорванных связей между блоками.
- Проверка логики на тестовых данных. Прогнать алгоритм на 2-3 примерах вручную или через трассировку и сравнить результат с ожидаемым.
Как трассировка помогает найти логический баг
Если код синтаксически верен, но выдаёт неправильный результат, проблема почти всегда в логике, а не в буквах. Здесь помогает классический приём — трассировка вручную.
- Трассировка
- Пошаговое выполнение программы «на бумаге» с фиксацией значений всех переменных после каждой строки или команды, позволяющее увидеть момент, где реальное поведение расходится с задуманным.
Составьте таблицу, где в шапке — имена переменных, а в строках — их значения после каждой операции. Пройдите так весь алгоритм на простом тестовом примере, взятом из условия задачи. Расхождение с ожидаемым результатом покажет точное место ошибки — это надёжнее, чем просто «читать глазами» распознанный текст.
Трассировочная таблица помогает увидеть, на каком шаге значение переменной стало неверным, и точно определить место ошибки — этот метод остаётся базовым инструментом отладки в школьном и вузовском курсе информатики.
Чек-лист самопроверки перед сдачей
Прежде чем считать задачу решённой, стоит пройтись по короткому списку типичных слабых мест — как в распознавании, так и в самой логике решения.
- Совпадают ли все скобки, отступы и регистр букв в переменных с оригиналом на фото.
- Не подставила ли нейросеть «более вероятный», но иной синтаксис вместо реального символа с фото.
- Есть ли в коде off-by-one ошибки — типичная путаница границ цикла на единицу.
- Обрабатываются ли граничные и пустые входные данные, а не только «удобный» пример.
- Совпадает ли количество стрелок и блоков в схеме с оригиналом, не пропущен ли скрытый цикл.
Почему нельзя доверять анализу без ручной проверки
Главная ошибка на этом этапе — попросить ИИ «найти баг» и сразу принять ответ, минуя собственную сверку. Если исходное распознавание содержало неточность, модель будет искать ошибку в несуществующем варианте кода и предложит правку, которая не решит реальную проблему задачи.
Что делать, если ИИ и трассировка дают разные результаты
От снимка до рабочего решения
Разбор кода и блок-схем по фотографии — это цепочка из нескольких равнозначных этапов, и слабое звено в любом из них обесценивает результат. Всё начинается с качества самого снимка: правильный свет, перпендикулярный ракурс и чёткий фокус закладывают основу, без которой даже мощная мультимодальная нейросеть не восстановит искажённые отступы или стёртые линии между блоками. Дальше важна дисциплина в работе с промптом — точная формулировка без запроса на «улучшение» синтаксиса и обязательная построчная сверка распознанного текста с оригиналом до перехода к анализу логики. Тот же принцип действует и для блок-схем: сначала проверяются найденные фигуры и направления стрелок, и только затем схема переводится в псевдокод и программу. Финальная проверка синтаксиса, трассировка переменных и тестирование на граничных случаях остаются на стороне пользователя — ИИ ускоряет разбор задачи, но не заменяет самостоятельный контроль результата.
Если под рукой оказалась задача по фото — пройдите по шагам из статьи на своём примере и сверьте результат распознавания с оригиналом, прежде чем доверять готовому решению.

 В государственном университете в Ереване в 1988 году получила высшее образование. По окончании университета получила специальность «Русский язык и литература». У меня стаж филолога 27 лет, проработала учителем русского языка и литературы. У меня высшая квалификационная категория (2010-2015гг).
 Добрый день! Меня зовут Оксана Анатольевна – репетитор русского языка по скайпу.